Обработка звука
Рассмотрим основные задачи, которые решаются для звуковых данных с помощью нейронных сетей.
Представление звука
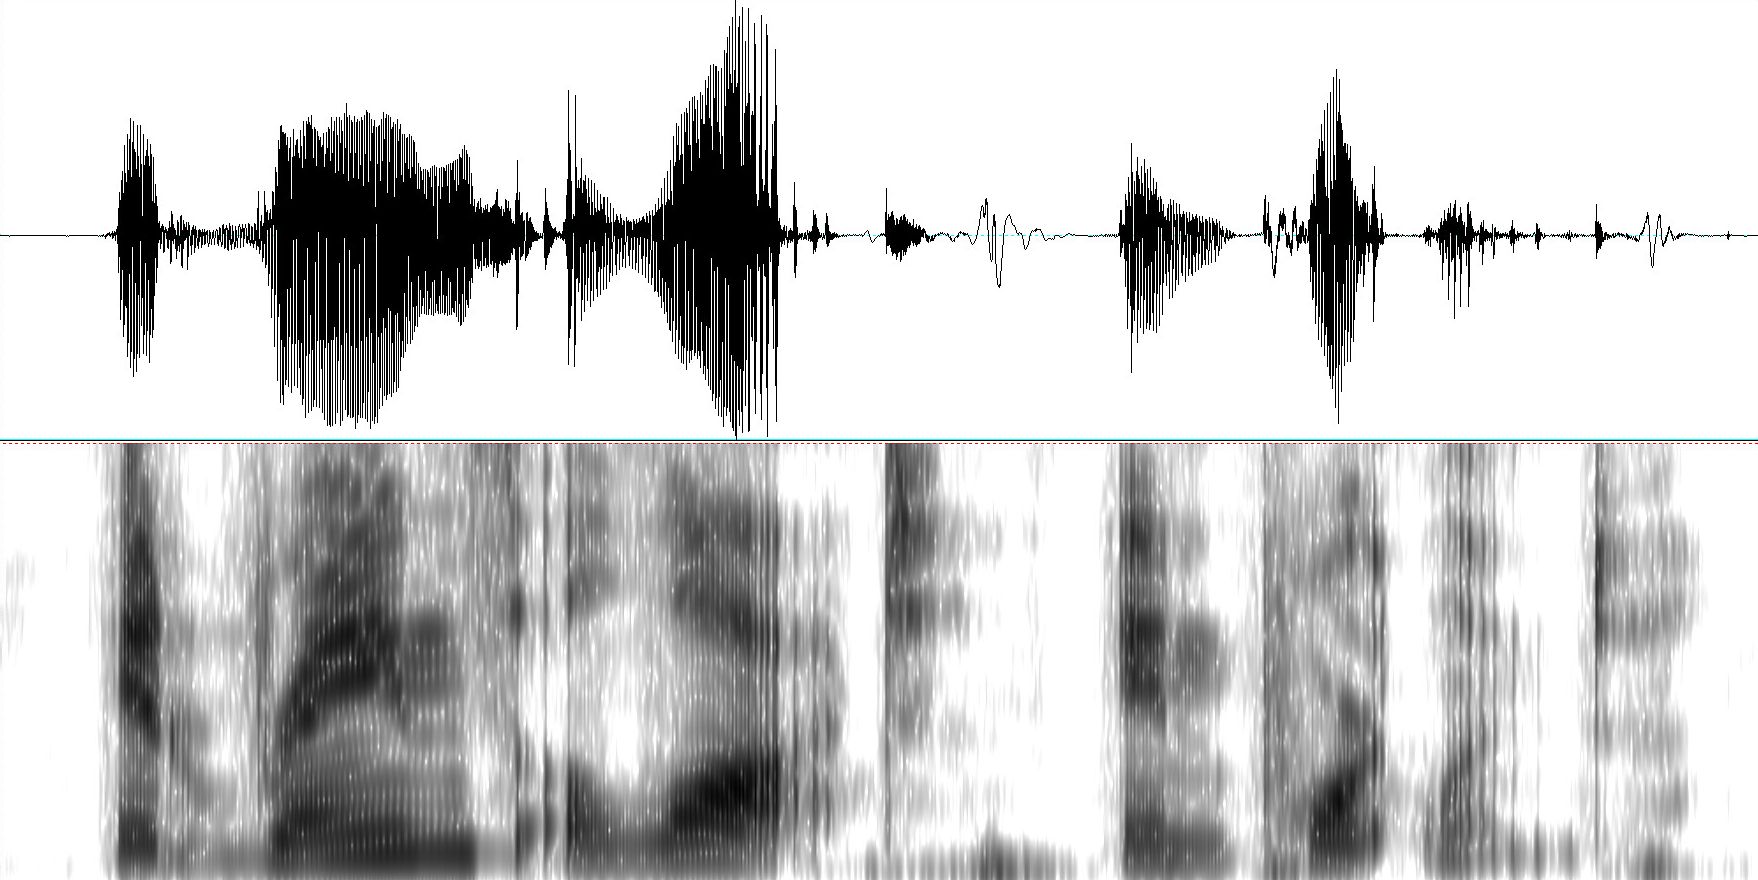
Звук для обработки представляется либо в виде wave-формы (динамики силы звуковой волны во времени [1]), либо спектрограммы (spectrogram [2]), описывающей представленность тех или иных частот во времени. Они показаны на рисунке сверху и снизу соответственно (источник):
Основные задачи обработки звуковых данных
Опишем основные задачи, возникающие при обработке звуковых данных.
Классификация звука (audio classification [3]) - отнесение звука к одной из заранее заданных категорий. Примеры:
-
Определение жанра, исполнителя и названия композиции записанной мелодии.
-
Идентификация по голосу - установление личности говорящего на основе уникальных характеристик его речи.
-
Анализ эмоций по голосу (интонации, тембру, скорости речи и другим акустическим характеристикам). Используется в колл-центрах и виртуальных ассистентах.
Сегментация звука (audio segmentation, speaker diarization) - разделение разговора нескольких собеседников на фрагменты, в которых говорит каждый из собеседников.
Это может использоваться для автоматической фокусировки камеры на говорящем спикере, транскрипции диалога и суммаризации проведённой видеоконференции.
Повышение качества звука (audio super-resolution, speech enhancement [4]). Цифровой звук имеет два уровня дискретизации: число бит, кодирующих сигнал в каждый момент времени, а также частоту моментов времени, в которые записывается сила звукового сигнала. Нейросетевыми методами можно повышать оба уровня дискретизации, улучшая качество воспроизведения.
Распознавание речи (automatic speech recognition, ASR [5]) - перевод звука в текст. Применяется для документирования переговоров, а также для автоматического формирования субтитров на видеоплатформах.
Генерация речи (text-to-speech, TTS, speech synthesis [6]) используется голосовыми помощниками. Родственной задачей является генерация музыки по жанру, нотам или словам песни.
Удаление шума (noise removal, speech enhancement [7]) - задача извлечения чистого речевого сигнала из шумной аудиозаписи. Применяется в системах видеосвязи и распознавании речи.
Разделение источников звука (audio source separation). Используется при разделении записанного диалога на фразы отдельных спикеров, а также при декомпозиции песни на голос, барабаны, бас и другие инструменты.
Сжатие аудио (neural audio compression) и генерация по сжатому представлению. Используется для компактного хранения аудиоданных.
Стилизация звука (voice conversion / voice cloning [8]) - трансформация речи под другого спикера. Это применяется в озвучивании аудиокниг, а в играх позволяет игроку говорить голосом своего персонажа.
Звук, как последовательность амплитуд звуковой волны (в wav-формате) или как последовательность звучащих в каждый момент времени частот (в виде спектрограммы) можно обрабатывать рекуррентными сетями. Более высокое качество достигается использованием механизма внимания и моделью трансформера.