Мониторинг сходимости
Для анализа сходимости метода стохастического градиентного спуска важно смотреть на динамику потерь на каждой итерации алгоритма. Особенно это важно при долгой и трудоёмкой настройке нейросетей, чтобы на ранней стадии оптимизации увидеть некорректную настройку определённых параметров. Поскольку в стохастическом градиентном спуске сдвиг весов производится на антиградиент по случайному минибатчу объектов, то и величина этого сдвига будет подвержена случайным колебаниям, как в примере ниже:
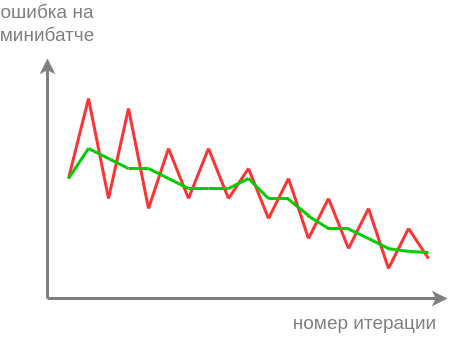
Для большей наглядности нам хотелось бы отслеживать сглаженную версию этой динамики, показанную зелёной кривой. Для этого существуют два подхода - скользящее среднее и экспоненциальное сглаживание. Оба метода на вход принимают зашумлённый временной ряд (в нашем случае - потерь на объектах минибатча), а на выходе выдают его сглаженную версию , причем сглаживание осуществляется динамически в каждый момент времени.
Скользящее среднее
Идея скользящего среднего заключается в выдаче усреднения по последним наблюдениям:
Это среднее можно эффективно пересчитывать по формуле
Вначале, пока наблюдений еще не накоплены, нужно усреднять по всем располагаемым наблюдениям.
Экспоненциальное сглаживание
Экспоненциальное сглаживание вычисляет сглаженную версию временного ряда по следующей формуле:
Гиперпараметр управляет степенью сглаживания.
Как именно влияет на результат?
Увеличение приводит к более слабому учёту новых данных и к более сильному - исторических. Поэтому сглаженный временной ряд будет получаться более гладким. Уменьшение уменьшает сглаживание. В частности, при , сглаженный ряд совпадает с исходным.
Если рекуррентно переписать зависимость только от , то получим, что экспоненциальное сглаживание выдаёт взвешенное усреднение по всем прошлым наблюдениям с экспоненциально убывающими весами:
Более детально об экспоненциальном сглаживании и его связи со скользящим средним можно прочитать в [1].