Использование похожей задачи
Перенос весов из другой задачи (transfer learning)
Предположим, нам нужно решить узкоспециализированную задачу A, такую как распознавание модели машины по её фотографии. Как правило, когда заходит речь о задаче с узкой специализацией, то данных для настройки модели оказывается мало, поскольку сбор объектов и их ручная разметка - это трудоёмкий процесс. Зато можно воспользоваться другой похожей задачей B, для которой собрано много обучающих данных и есть уже настроенные и хорошо зарекомендовавшие себя модели.
Например, можно воспользоваться датасетом ImageNet [1], в котором свыше 14 миллионов размеченных изображений на 1000 классов, содержащих типовые объекты, встречаемые на практике, такие как кошки, собаки, машины, грузовики, дома, прицепы, компьютеры и т.д. Для этого датасета уже существует большой набор настроенных моделей [2].
Классы ImageNet хотя и не совсем соответствуют решаемой задаче определения марки машины по её фото, но в целом и та, и другая задача опирается на похожий набор признаков - чтобы распознать марку машины, нужно вначале извлечь углы распознаваемого предмета, определить его цвет, извлечь типовые графические паттерны, отвечающие резине колёс, бликам на стёклах, цветовым переливам на форме кузова и т.д. А эти признаки как раз и извлекаются в уже настроенных моделях на ImageNet!
Поэтому вместо того, чтобы обучать модель под целевую задачу с нуля, рекомендуется вначале извлечь информативные высокоуровневые признаки (high level features) из промежуточных слоёв уже настроенных моделей на похожей задаче, как проиллюстрировано на схеме ниже:
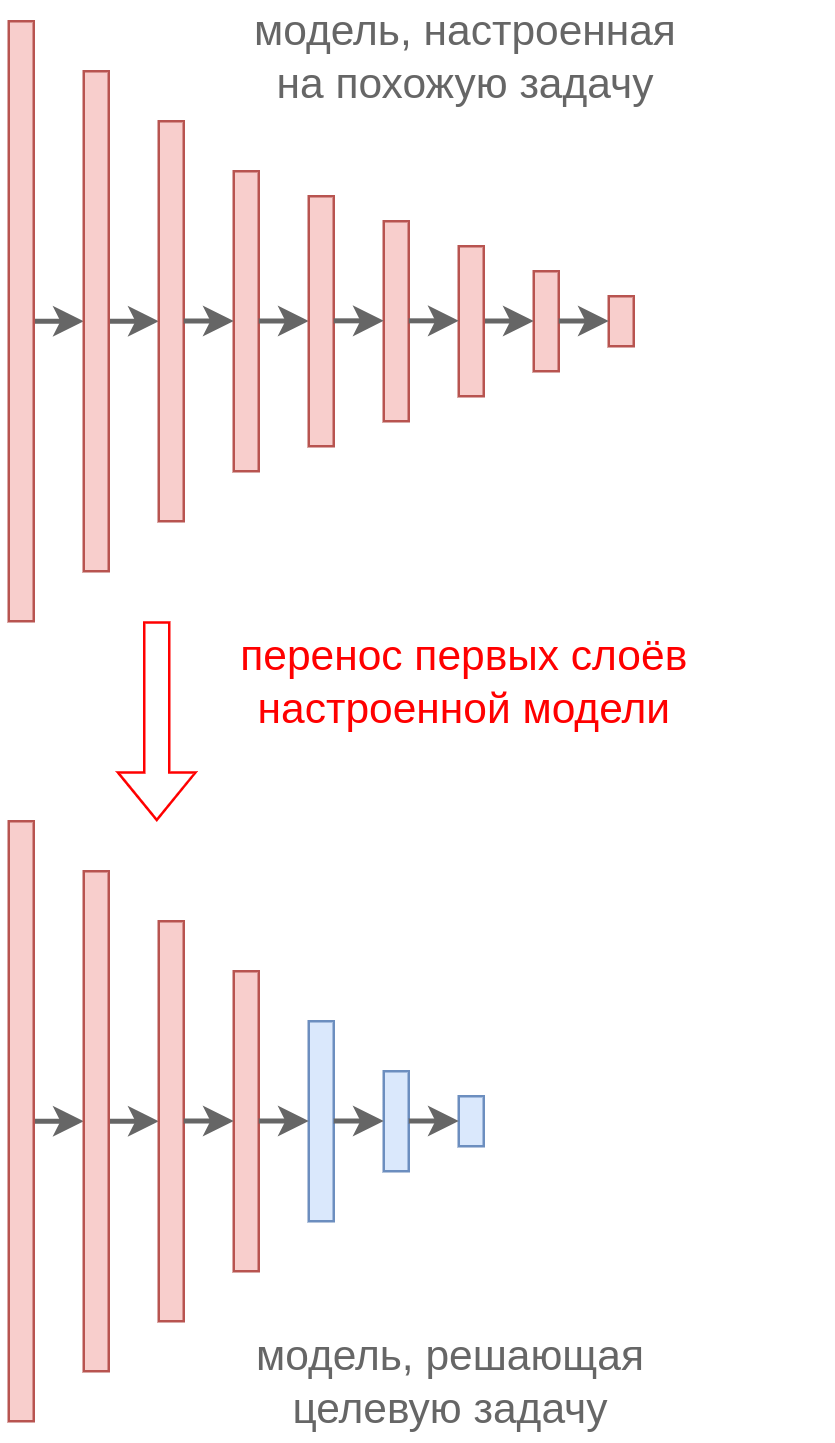
Таким образом, веса первых слоёв модели, решающей задачу B (красные), переносятся в неизменном виде на первые слои модели, решающие задачу A. Это называется жёсткая общность весов (hard weight sharing). Под целевую задачу A настраиваются лишь последние слои (обозначенные синим цветом), что позволяет сэкономить на сложности настройки и успешно обучить модель на выборке меньшего объёма. Чем больше размеченных данных мы имеем для решения целевой задачи A, тем большее количество последних слоёв мы можем выделить для настройки под эту задачу, не переобучившись.
Выбор похожей задачи
Тип похожей задачи может совпадать, как в примере выше, где и задача A, и задача B были задачами классификации изображений.
Но в качестве вспомогательной задачи B можно выбирать и другой тип задачи. Например, задача A - классификация изображений, а задача B - генерация изображений с помощью автокодировщика или генеративно-состязательной сети [3] (в этом случае заимствуются первые слои дискриминатора). Другой задачей может быть определение того, показан ли на изображениях один и тот же объект (под разными углами) или разные, используя сиамские сети (instance discrimination).
Если в качестве вспомогательной задачи B используется задача обучения без учителя (unsupervised learning), не использующая внешнюю разметку, то это позволяет обучать её очень точно на гораздо больших объемах данных, поскольку ручная разметка для них не требуется!
Донастройка перенесённых весов (finetuning)
Поскольку задача A всё же несколько отличается от задачи B, то низкоуровневые признаки, перенесённые с первых слоёв, могут немного отличаться. Добиться небольшой подстройки весов начальных слоёв под исходную задачу можно двумя способами:
-
После переноса весов (hard weight sharing) донастроить все веса модели, решающей целевую задачу A, с малым шагом обучения (learning rate), используя небольшое число итераций. Такая аккуратная донастройка изменит веса, но несильно и позволит ранним слоям приспособиться к решению целевой задачи A. Также можно донастраивать модель, используя шаг обучения, который плавно увеличивается с нуля до некоторого значения. Это называется разогревом модели.
-
Как альтернатива, можно настраивать все веса с обычным шагом обучения, но с дополнительной регуляризацией , препятствующей сильному отклонению весов целевой модели задачи A от весов референсной модели, решающей задачу . Это похоже на мягкую связку весов, но теперь они привязываются не друг к другу, а к весам модели, решающей похожую задачу.
Дополнительно о представленных подходах можно прочитать в [4], а в [5] доступна иллюстрация кода, реализующего эти методы.